零、缘起:Opus 5.5 刷屏之后,一次被迫动手的技术祛魅
Claude Opus 5.5 发布以后,全网技术圈几乎被各种「一句话用代码生成商业大片」的演示刷屏了。从硅谷创业公司的极简发布片,到几分钟讲完大气环流与中华五千年历史的线稿科普,视觉利落、卡点精准,看着确实让人心痒。
但先别急着神化。如果我们把这套「大模型拍视频」的黑盒拆开,会发现 Opus 5.5 本身根本不会直接输出 .mp4 视频文件。它的真实工程链路其实非常清晰:
- 用代码画每一帧:大模型先编写前端或图形代码——常见的是原生 HTML/CSS/SVG、HTML5 Canvas、p5.js、Three.js,或者是工程化框架 Remotion、数学动画引擎 Manim——把分镜、排版与动画逻辑跑在网页或画布里;
- 无头浏览器逐帧截图:启动本地 Headless Chrome,沿着时间轴一帧一帧截取高清画面;
- 音轨合成与混流封装:配乐通常由 Web Audio API 或 Python 脚本(如
wave+numpy)按乐理程序化合成,需要人声解说时再接一层 TTS;最后把图像序列和音轨一起喂给 FFmpeg,压制成标准的.mp4成片。
看穿这条流水线,你就能立刻明白为什么我们在网上看到的 Opus 5.5 视频,绝大多数都是动态图形(Motion Graphics)、手绘/线稿/水墨动画、硬核科普讲解、SaaS 与桌面软件发布片,而几乎看不到真人写实镜头。
因为归根结底,代码大模型真正统治的领域是「精确排版、数学物理曲线、UI 状态机与节拍同步」,而不是拟真人物实拍。如果片子里确实需要真人特写或写实空镜,业界的标准做法也是「混合编排」:先调用 Runway、Seedance、Higgsfield 这类 C 端视频生成模型产出写实底片,再交由代码智能体负责时间轴剪辑、动态字幕包装与转场合成。
搞懂原理之后,一个很现实的问题摆在我面前:我手里一直没搞定稳定的 Claude 账号,也没法顺畅使用 Claude Code。
但我转念一想:既然底层逻辑是「写确定性前端代码 + 本地无头浏览器截帧 + FFmpeg 合成」,这并不是绑定在某一家闭源模型身上的专属魔法。那我能不能直接用手头现成、稳定可用的其他家主力大模型——比如 Gemini、Kimi 和 MiniMax——来实现同样的工作,甚至利用它们各自独有的多模态能力做出更好的效果?
说干就干。我花了一个周末的时间,先把我在 B 站、Linux.do、GitHub 和 X 上收集到的大佬公开提示词原文与代表性案例做了一次彻底拆解;随后以此为底座,结合 Gemini、Kimi、MiniMax 三家截然不同的模型禀赋与原生工具链(Harness),分别为它们量身定制了三套「用代码拍视频」的技术方案,并拿我自己写的开源 macOS 应用 TokenUse 作为统一考题,让三家各自独立拍出了一支 1080p @ 60fps 的产品宣传片,顺带拉出了精确到毫秒与个位数 Token 的真实账单。
一、拆透近 60 个开源案例:代码拍视频为什么能出「商业质感」?
在动手写第一行适配代码之前,我先在大模型的辅助下,对社区沉淀的开源与公开案例做了一次系统性摸底(重点参考了 GitHub 上归档极为完整的 joeseesun/opus-video-prompts 及各社区帖子,汇总了来自 X、B 站、Linux.do、GitHub 等渠道的 近 60 个开源案例、18 份作者本人公开的提示词原文与 9 种技术路线——包括 Deedy 号称 1 分钟花 2 美元跑出来的推理创业片、WY 的中华五千年线稿动画与带 TTS 双语字幕的大气环流科普、Danny Stuart 的产品宣传片,以及 @twoclipping (zero) 收藏量极高的商业极简模板)。
把这近 60 个开源案例横向扒完,首先确立了一个最核心的选型认知:
为什么软件产品片一定要用「代码渲染」,而不是直接丢给 Sora / Veo / 海螺?
纯 AI 视频扩散模型擅长光影氛围,但只要画面里出现真实的软件界面、小字号仪表盘数字、中英文混排标签或品牌 Logo,几乎必然出现乱码与果冻形变;而代码渲染出来的文字、圆角、毛玻璃和 SVG 图标与真实软件 100% 同源矢量锐利,物理曲线精确到毫秒。
1.1 技术路线怎么选?(以及为什么要做「零外部 npm 依赖」改造)
社区里的 9 种玩法看似眼花缭乱,按投入产出比收敛下来其实就五条主线:
| 场景类型 | 推荐技术栈 | 实战取舍建议 |
|---|---|---|
| SaaS / 桌面软件宣传片、动态字效 | HTML/CSS/SVG + Chrome CDP 截帧 + FFmpeg | 主力首选。零脚手架开销,字体渲染、毛玻璃、阴影与真实 UI 完全同源 |
| 数据可视化 / 几何粒子 / 示波器 | HTML5 Canvas 2D + 固定伪随机种子 | 适合局部嵌入 HUD 曲线或波形;必须锁死 PRNG 种子保证多进程截帧一致 |
| 真 3D 空间运镜 / 体积光照 | Three.js / WebGL | 仅在确需三维网格或 PBR 材质时启用;普通卡片空间翻转用 CSS perspective 足够 |
| 团队长期复用的多镜头流水线 | Remotion (useCurrentFrame + spring) |
工程化强,但单次出片会拖入数百 MB node_modules,在云同步目录下极重 |
| 数学公式推导 / 算法几何科普 | Manim (Python) | 公式变换王者,但不适合还原现代 macOS / Web 毛玻璃应用界面 |
在实际落地时,我还针对自己的 macOS 工作环境做了一项关键改造——彻底实现「零外部 npm 依赖」:
原版社区脚本大多依赖安装 playwright、puppeteer 或 remotion(动辄下载几百 MB 浏览器镜像与上万个碎文件,放在 iCloud Drive 目录里简直是同步灾难),音频脚本又喜欢引 scipy(极易遇到架构或环境冲突)。而在现代环境下,Node.js(v22+ / v26+)已经原生内置全局 WebSocket,可以直接用几十行代码连上本机现成 Chrome 的 CDP(Chrome DevTools Protocol) 并发截帧;音频合成则只用 Python 标准库 wave 加 numpy FFT 频域滤波就能搞定。整个项目 npm install 数量严格为 0,干净利落。
1.2 决定成片是「Apple 发布会」还是「廉价 PPT」的 7 条工程铁律
很多人第一次让大模型写网页录屏,做出来一股浓浓的“AI 塑料味”或者卡顿掉帧。复盘头部案例后我发现,真正拉开商业质感差距的不是华丽的形容词,而是写死在提示词里的 7 条硬核工程铁律:
- 纯时间函数
window.seek(t)(彻底封杀异步动画)
画面中所有元素的位移、缩放、透明度、圆环进度、滚动数字乃至鼠标坐标,必须唯一由当前秒数t闭式计算得出。严禁使用 CSStransition、@keyframes、setInterval或跨帧累加状态。这样不仅彻底杜绝无头浏览器截帧时的卡顿丢拍,还能让多个浏览器进程按任意顺序并行渲染不同时间片。 - 闭式二阶阻尼弹簧(Closed-Form Spring)替代廉价回弹
抛弃模板味极重的cubic-bezier果冻乱颤,统一使用阻尼比ζ ≈ 0.82–0.86的二阶系统阶跃响应公式,只保留约0.8%的克制微过冲,一秒复刻 Apple Keynote 那种沉稳跟手的物理质感。 - BPM 节拍网格锁死剪辑与音效波峰(Beat-Grid & Peak Offset)
以120 BPM(1 拍 = 0.5s,1 小节 = 2.0s)建立绝对时间网格:镜头硬切严格踩在小节重拍,UI 点击踩在正拍;更重要的是,合成点击音、磁吸音时,必须用音效的**振幅波峰位置(Peak Offset)**去对齐视觉触发帧,而不是把 WAV 文件头部简单对齐。 - 显式
<banned>反 AI 塑料感黑名单
在提示词里点名封杀大模型最爱滥用的廉价特效:粒子爆炸、RGB 色差故障、霓虹发光汤(Neon Glow Soup)、镜头光晕、80 年代透视网格地板、大标题末尾句号。 - Chromium 合成器底层避坑红线
- 缩放层严禁挂
will-change: transform:否则 Chrome 会把初始尺寸栅格化缓存成低清位图,镜头推近时文字直接发糊; preserve-3d容器严禁直接设opacity < 1或filter:根据 W3C 规范这会强制把 3D 空间拍扁成 2D 平面;file://本地协议禁用<script type="module">:统一用经典<script src="...">挂载全局对象,避开无头浏览器本地跨域拦截。
- 缩放层严禁挂
- 镜头内 3 子帧超采样快门模糊(Subframe
tmix)+ 母带级响度归一
纯 60fps 的锐利 CG 动画如果没有运动模糊,肉眼看会有生硬的“电子幻灯片感”。我们在每个镜头的切点边界[sceneStart, sceneEnd)内,对每帧超采样[t - Δt, t, t + Δt]3 个子帧(相当于180fps采样),通过管道喂给 FFmpeg 执行tmix=frames=3:weights='1 2 1'融合出真实的 170° 电影快门动态模糊——同时严格把采样钳制在当前镜头边界内,确保切点前后 0% 跨镜鬼影;音轨统一经loudnorm=I=-14:TP=-2.5:LRA=11与-ar 48000标准化,视频输出yuv420pBT.709tv色域,兼容所有播放器。 - 运行时
getBoundingClientRect()实测靶心(拒绝盲猜像素)
大模型盲写硬编码坐标几乎必出现“鼠标点在按钮旁边”的穿帮事故。强制要求在window.seek(t)运行时实时调用getBoundingClientRect()读取目标控件中心点,光标点击与波纹扩散永远分毫不差。
二、同题竞技规则:用「原生全家桶 Harness」拍同一个真实项目
有了这套通用工程底座,接下来就是重头戏:把底座分别适配给 Gemini、Kimi 和 MiniMax。
2.1 统一考题:macOS 原生开源应用 TokenUse
为了防止大模型拿空洞的假数据糊弄过关,我选了自己正在维护的真实开源应用 TokenUse 作为统一拍摄对象。
这是一款用 Swift 6 + SwiftUI 编写的 macOS 屏幕边缘毛玻璃组件,平时吸附在屏幕左右边缘(48–50pt 胶囊 + 蓝色彗星活跃环),点开后同屏监控 Codex、Antigravity、MiMo Token Plan、Kimi Code、MiniMax 五大 AI 编程助手的多账号实时配额(电池式剩余百分比与 5h/7d 重置倒计时),支持 一键原子切换 Codex 满血账号(自动安全备份 auth.json)、双显示器跨屏磁吸停靠、邮箱隐私打码、48 小时重置券过期系统通知,以及 本地会话日志 + 官方云端账单的分模型 Token 对账。
选它当考题有两个妙处:一是它的真实 UI 细节极多(5 家真实品牌图标、吉祥物、电池条、滚动账单、边缘浮窗),非常考验大模型读源码还原真实产品的功力;二是——等三家拍完视频,我直接用 TokenUse 同款底层日志解析器去扫它们仨留在本机数据库里的会话记录,就能拿到零水分的精确耗时与 Token 账单!
2.2 为什么要坚持「原生全家桶 Harness」测试?
在公布方案和账单之前,必须先交代清楚本次测试的调用方式。
这次我并没有采用那种“搭一套一模一样的第三方开源壳子,只替换底层 API Key 和模型名”的实验室测法,而是彻头彻尾采用了各家原生的「模型 + Harness 全家桶」方式:
- Gemini 组:在 Google DeepMind 的 Antigravity 中直接原生调用 Gemini(
Gemini 4 Argon High); - Kimi 组:让 Antigravity 通过 Orca CLI 编排独立终端,直接拉起月之暗面原生的 Kimi Code CLI(驱动
kimi-code/k3.1-pro); - MiniMax 组:直接运行稀宇原生的 MiniMax Code CLI(
mcode)(驱动minimax/MiniMax-M3,并直接调用其内置mcode-tools与订阅内的语音、图像接口)。
为什么这么测?因为「用代码拍视频」是一个典型的重度多步 Agent 任务(横跨读源码、抽资产、写合成器、起 Chrome 截帧、跑 FFmpeg、看图审片、看视频听音轨返工)。在真实世界里,决定出片上限和稳定性的从来不只是裸模型的写代码能力,而是「模型推理特性 × 原生 CLI 工具链 × 原生多模态自检闭环」的整体协同。对于买了各家 Coding Plan 订阅的开发者而言,用各家最顺手的原生全家桶跑出来的结果,才是最具参考价值的真实战斗力。
三、因材施教:Gemini、Kimi、MiniMax 三套定制方案深度复盘
虽然底层都遵循前面提炼的 7 条铁律,但这三家模型的脾气、上下文容量与多模态边界差异极大。照搬同一份提示词只会水土不服,因此我为它们量身定制了三条截然不同的技术路线。
3.1 Gemini 方案:百万上下文源码穿透 + 原生 .mp4 视听直读终审(22 分钟极速流)
先看 Gemini。在 Antigravity 原生环境下,Gemini 有两项极其霸道的先天优势:
第一是百万级超长上下文窗口的源码穿透力。以往用社区模板做产品片,往往得人工截好几张图或者写上千字的 UI 结构说明,稍不留神做出来的还是千篇一律的“硅谷通用 SaaS 灰框模板”。而在 Gemini 方案里,我直接让它一口气通读 TokenUse 的 README.md、ContentView.swift、EdgeWindowManager.swift、ProviderModels.swift 以及 Resources/ 下的全部真实图标。它不需要任何人工喂图,就能把 macOS 右侧屏幕边缘的毛玻璃停靠栏、蓝色彗星活跃环、五平台双列电池卡片乃至 14% 橙色预警一键热切到 100% 满血绿电的交互细节 1:1 复刻出来。
第二项优势则是对原版 Opus 5.5 方案真正的降维打击——原生 image_in + video_in + audio_in 全模态直读。
要知道,Claude Opus 5.5 本身只有图像输入能力(image_in),它写完视频后只能抽几张静态 JPG 盲猜运动顺不顺、声音对不对。而针对 Gemini,我设计了 「3-Gate 多模态质检工作流」:
- Gate 1(源码采风与节拍分镜):通读仓库源码与图标,输出
120 BPM(6 幕 × 4s = 24s)分镜与音效时刻表; - Gate 2(4 秒拼图探针快检):运行
node render.mjs --probe,4 秒内直出3×4共 12 帧巡检拼图probe-sheet.png,由 Gemini 视觉自检中英文混排折行(配合专门加装的 CJK 防孤字护栏与tabular-nums等宽数字)以及getBoundingClientRect()光标点击精度; - Gate 3(全量渲染 + 原生直读
.mp4终审):4 并发渲染合成带 170° 快门模糊的.mp4成片后,直接把完整的.mp4视频文件喂回给 Gemini,让它像真人导演一样同时“看画面流畅度 + 听电子配乐与点击音效卡点”,确认切点干净无残影后一次交付。
最终 Gemini 仅用 36 轮交互、22 分 15 秒 就一气呵成跑完了全流程,成片是一支非常丝滑的连续暗色毛玻璃桌面实机演示流。
3.2 Kimi 方案:深度思考四模块解耦 + 声波图视觉门禁 + 瑞士杂志昼夜美学
接着测试 Kimi。我通过 Orca CLI 在工作区拉起了原生的 Kimi Code CLI(kimi-code/k3.1-pro)。在研究了它的底层配置(默认开启 always_thinking: max)与内置工具后,我摸清了 Kimi 的真实能力边界,也由此定制了一套完全不同的打法:
第一,怎么破解「看得见视频,但听不见声音」?
实测发现,Kimi Code 原生具备 image_in + video_in 能力——它可以直接调用内置的 ReadMediaFile 工具读取渲染好的 .mp4 视频流来检查动态画面(这已经比只能看静态单帧的 Opus 5.5 强出一截),但它没有 audio_in(无法直接听音频)。
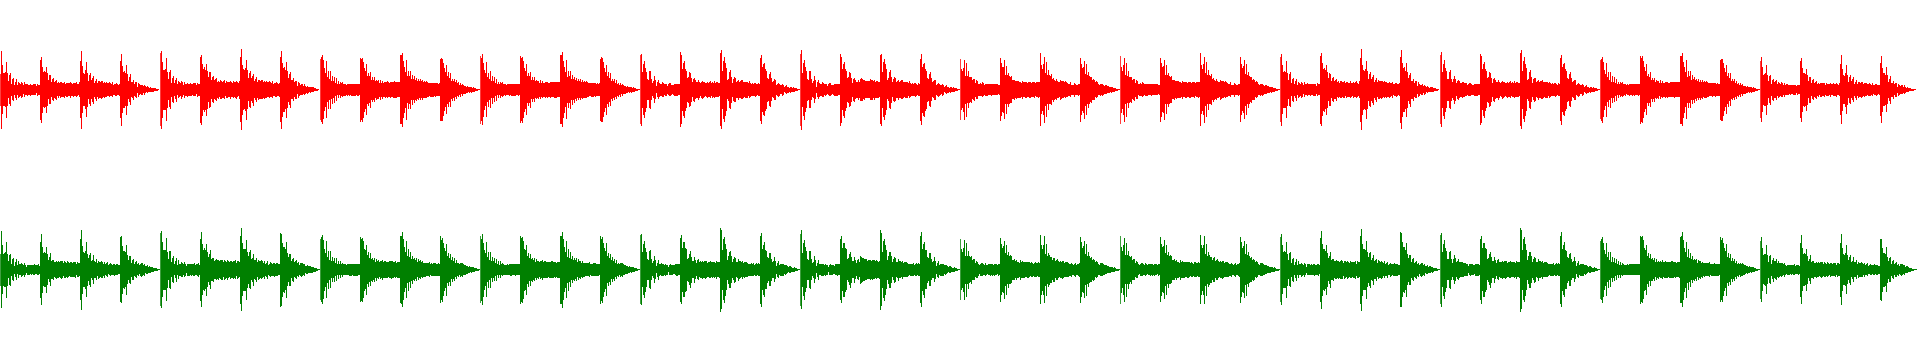
为了让没有“耳朵”的 Kimi 依然能严控配乐卡点与广播级响度,我为它定制了 「VisualSpectro 声波视觉化 + EBU R128 数值双门禁」:
- 强制要求
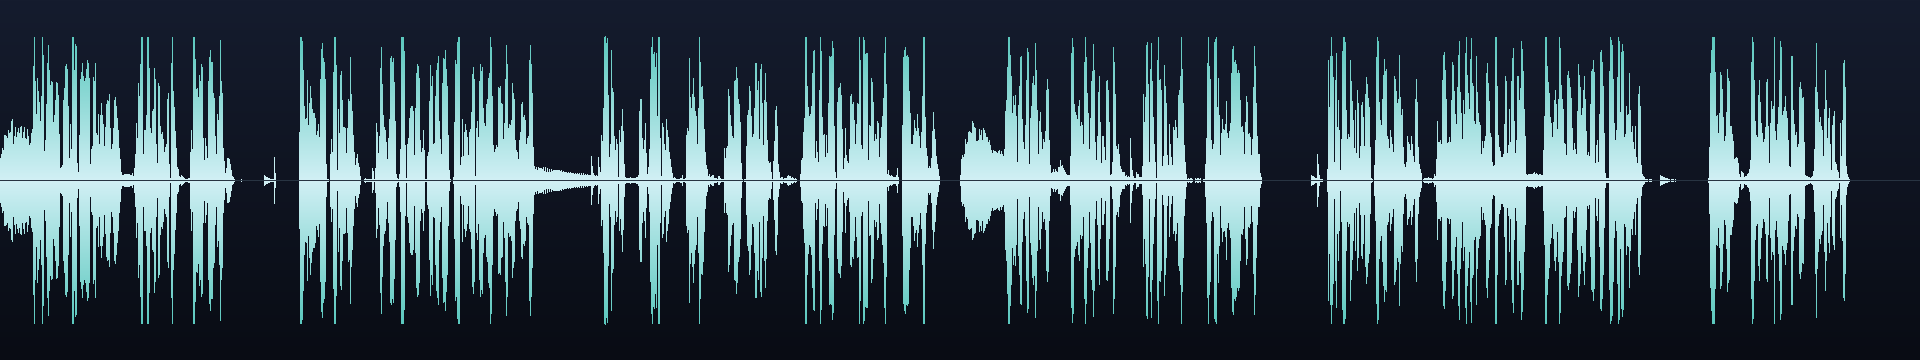
audio.py在合成完120 BPM配乐后,额外导出一张1920×360的节拍网格声波图audio-waveform.png(刚好每160px对应 1 个 2 秒小节),让 Kimi 用ReadMediaFile“用眼睛看声音”——核验每一小节重拍的瞬态脉冲是否精准落在网格线上、包络是否饱满无断档; - 在混流阶段强制跑
ffprobe+ebur128数值断言。
结果这道门禁在实战中立了大功! Kimi 在自检时靠这套组合拳,敏锐地抓出了两个极隐蔽的工程坑:一是 FFmpeg 的 loudnorm 滤镜默认会把音频暗中升采样到 96kHz;二是 WAV 母带虽然压在 -1.5 dBTP,但经过有损 AAC 编码后真峰值微超标到了 -1.4 dBTP。Kimi 当场自行修改管线,锁死 -ar 48000 并把响度真峰值预留到 TP=-3 裕量,重跑后一次性达标(-14.7 LUFS)。
第二,适配 always_thinking: max 的四模块解耦架构。
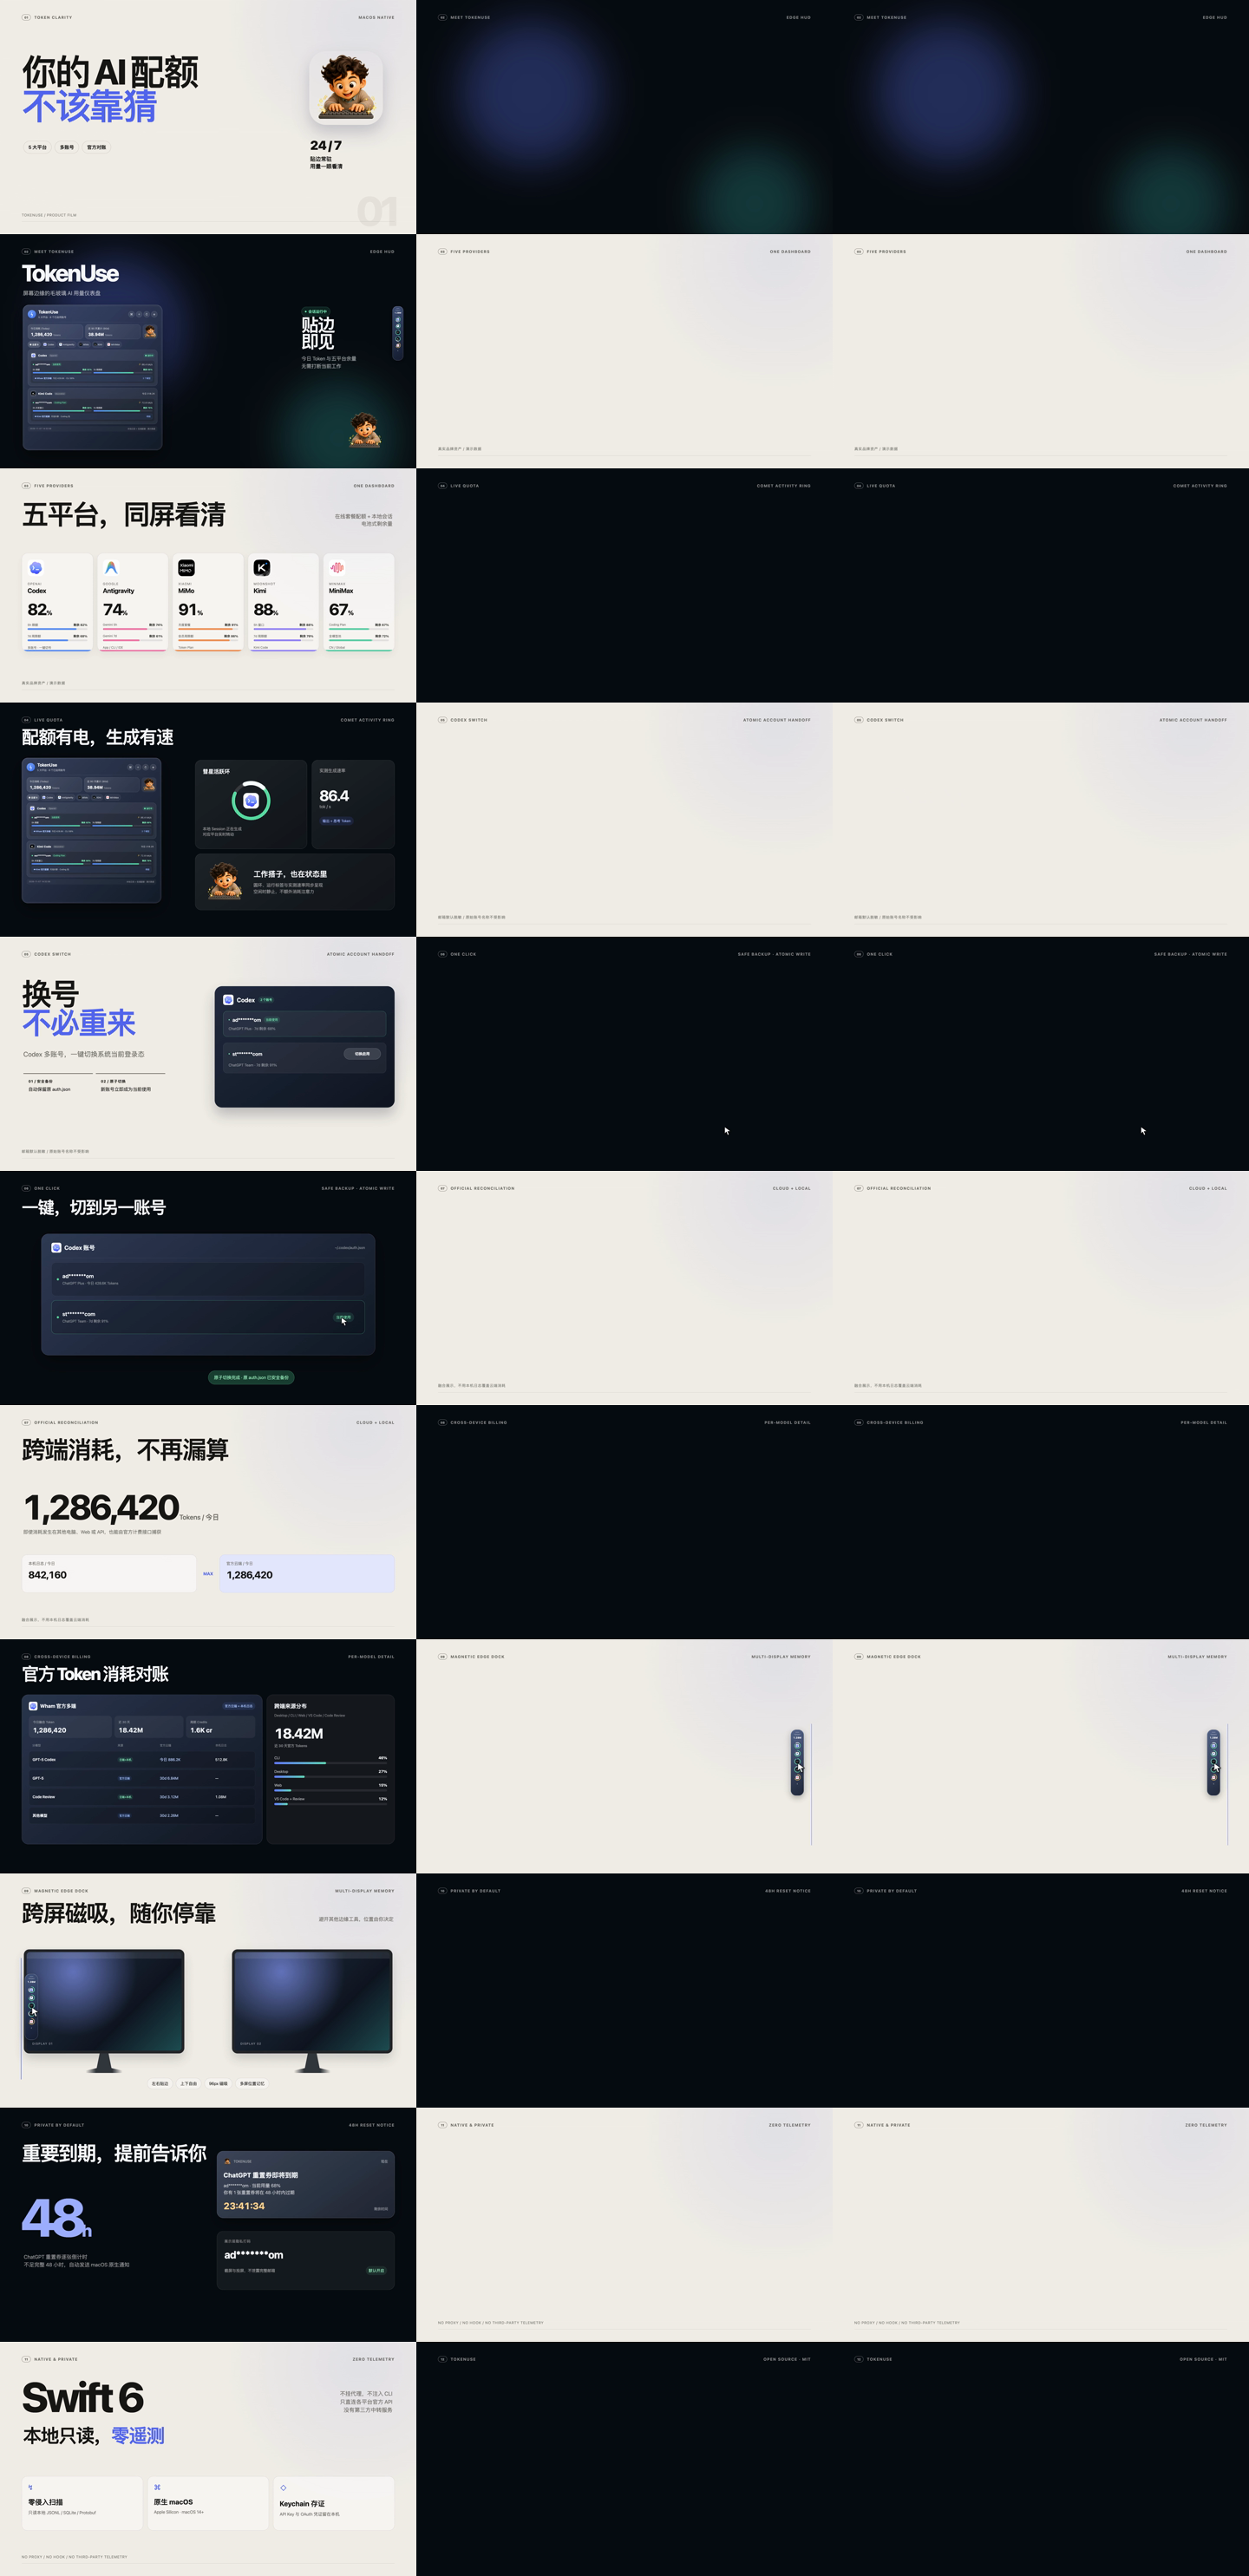
k3.1-pro 默认满血深度思考,逻辑极其绵密严谨。如果让它把几兆真实图标的 Base64 字符串和几千行渲染逻辑全塞在一个单文件 HTML 里输出,既浪费宝贵的输出 Token 又容易拖慢推理。因此我规定 Kimi 采用 4 文件解耦:build-assets.mjs 自动调用 macOS 原生 sips -Z 320 缩略真实图标并生成 window.ASSETS(零手敲 Base64)、engine.js 封装阻尼弹簧与实时靶心测量、index.html 专注舞台编排、render.mjs 负责并发渲染,并在 Gate 3 自动抽取全部 11 个硬切点的切前最后一帧与切后第一帧 拼成 cut-boundaries.png,用视觉工具逐一验明 0% 跨幕混叠。
第三,意外惊艳的「中文瑞士杂志昼夜交替」导演审美。
Kimi 交出来的成片风格和 Gemini 截然不同——它没有走到底的暗黑科技风,而是设计了 12 小节 × 2 秒的「高质感暖白纸感观点幕(#f2efe8)↔ 深邃曜石黑 Bento 实机幕」昼夜交替硬切。尤其是它的中文短句凝练度极高,写出了 “你的 AI 配额,不该靠猜”、“换号,不必重来”、“TokenUse — 让每一个 Token 都有数” 这样极具呼吸感与平面海报张力的对仗文案。
3.3 MiniMax 方案:订阅自带「文字 + 语音 + 图像 + 视听理解」全家桶,终结代码视频最后两块短板
把 Gemini 和 Kimi 的两支 24 秒成片放在一起看,虽然 UI 锐利、弹簧丝滑、卡点精准,但纯单模态代码视频始终有两个挥之不去的遗憾:
- 「默片感」:没有真人配音解说时,观众的眼睛必须在“阅读屏幕大字”和“观察复杂 UI 交互细节”之间来回打架;
- 「纯 CSS 渐变的塑料感」:只靠 CSS
radial-gradient很难做出 Apple 或 Linear 发布会那种温润建筑光影、暗色曜石折射等摄影级桌面氛围——可要是全交给 AI 视频模型生成,UI 上的字又会糊成乱码。
而轮到 MiniMax 时,它最大的王牌浮出水面了:我的 MiniMax 订阅里,直接把多模态全家桶配齐了!
除了主力代码智能体 MiniMax-M3(通过原生 CLI mcode 驱动),我可以直接调用高清语音大模型 speech-2.8-hd、文生图大模型 image-01,外加 mcode-tools 内置的 Matrix 视频理解(videos_understand)与图像理解(describe_images)多模态质检套件。
于是,在 MiniMax 方案上,我彻底打破了前两家的纯前端框架,设计了**「Voice-First 声画锁相环 + 三明治光学合成」**三模态协同架构:
1. Voice-First 声画锁相环(人声呼吸决定时间轴,拒绝硬塞配音)
做过视频剪辑的朋友都知道,千万不能先拍脑袋写死“每幕 4 秒”,再去生成配音往里硬塞——那样要么语速像机关枪,要么尾音被生硬切断。
在 MiniMax 方案中,第一步是语音先行(build-voiceover.py):
- 并发调用
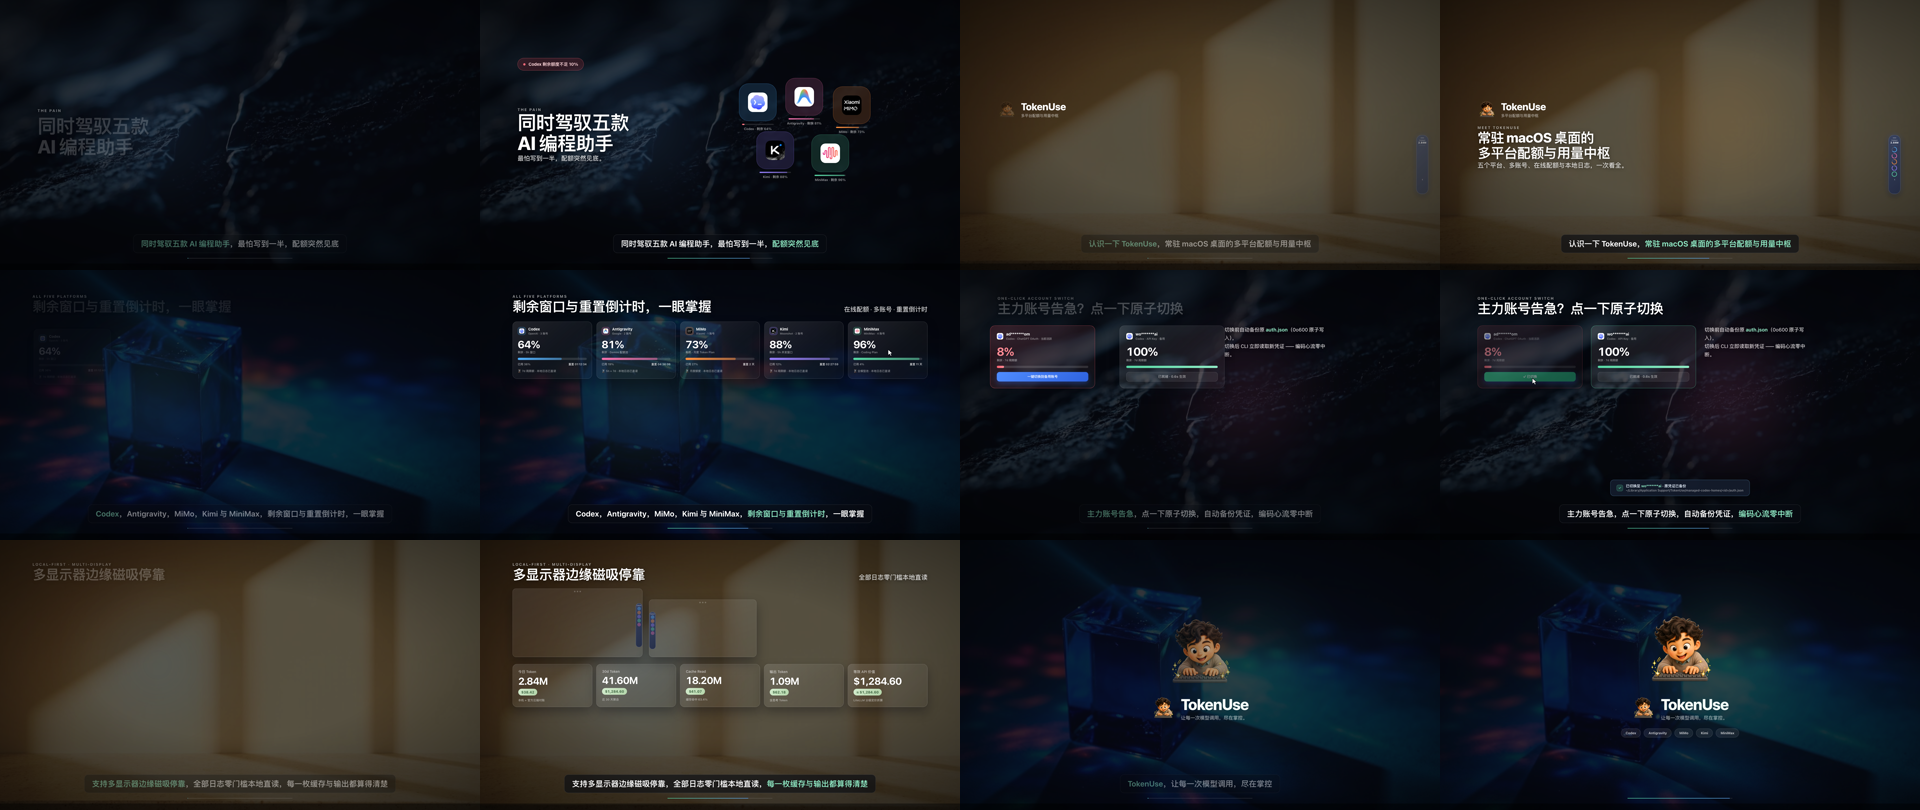
speech-2.8-hd(选用温润沉稳的发布会男声Chinese (Mandarin)_Gentleman,speed: 1.05),开启subtitle_enable: true,仅用2.25 秒挂钟时间就并发合成了全片 6 幕共212字的中文解说词(净语音38.15s),比如开场白:“同时驾驭五款 AI 编程助手,最怕写到一半,配额突然见底。” 以及切号高潮幕:“主力账号告急?点一下原子切换,自动备份凭证,编码心流零中断。” - 直接解析接口返回的毫秒级字幕时间戳(
subtitle_file),在每幕前后自动留出0.38s ~ 0.45s的自然呼吸气口(片尾留1.35s余韵),反向推算出全片精确到帧的全局唯一时间轴timeline.js(总长44.033 秒/2,642帧)。 - 随后
audio_mix.py根据人声干声计算平滑包络(Attack25ms/ Release280ms),执行专业电台级的 Sidechain Ducking(包络闪避混音)——每当男声开口讲述时,底层的电钢琴泛音配乐自动柔和压低-7.5dB;每到分句停顿与转场气口,配乐与 9 处交互点击拟音自然浮起。
2. 三明治光学合成架构(AI 画光影质感,代码画精准界面)
为了兼得摄影级氛围与零乱码 UI,我将 1920×1080 舞台拆成了四层“三明治”:
- Layer 0(AI 光学摄影底板):并发调用
image-01生成 3 张严禁包含任何文字与 UI 框的 16:9 高清光学底板——暗色曜石玻璃波纹(obsidian-wave.jpg)、北欧暖光洞石桌面(warm-studio.jpg)、深海蓝宝石棱镜散射(aurora-prism.jpg),在window.seek(t)中做1.02 → 1.07的极克制呼吸推镜; - Layer 1(高对比度光学遮罩 Scrim):铺设半透明墨色/暖雾遮罩,锁死前景文字对比度恒大于
7:1; - Layer 2(100% 确定性代码界面):提取仓库真实图标,用闭式阻尼弹簧驱动毛玻璃胶囊、五平台电池配额与实时测量靶心的指针交互;
- Layer 3(毫秒级同步发布会字幕条):紧扣
timeline.js时间戳,在底部安全区实时渐显并高亮当前朗读词句。
3. 全程零人工干预,两次教科书级「多模态自愈」名场面!
最让我惊喜的,是在 mcode exec --permission full 全自动无人值守运行期间,MiniMax-M3 配合 mcode-tools 多模态工具上演了两次极其硬核的自我纠错闭环:
- 第一次:视觉门禁揪出遮挡与对比度瑕疵(Gate 2)
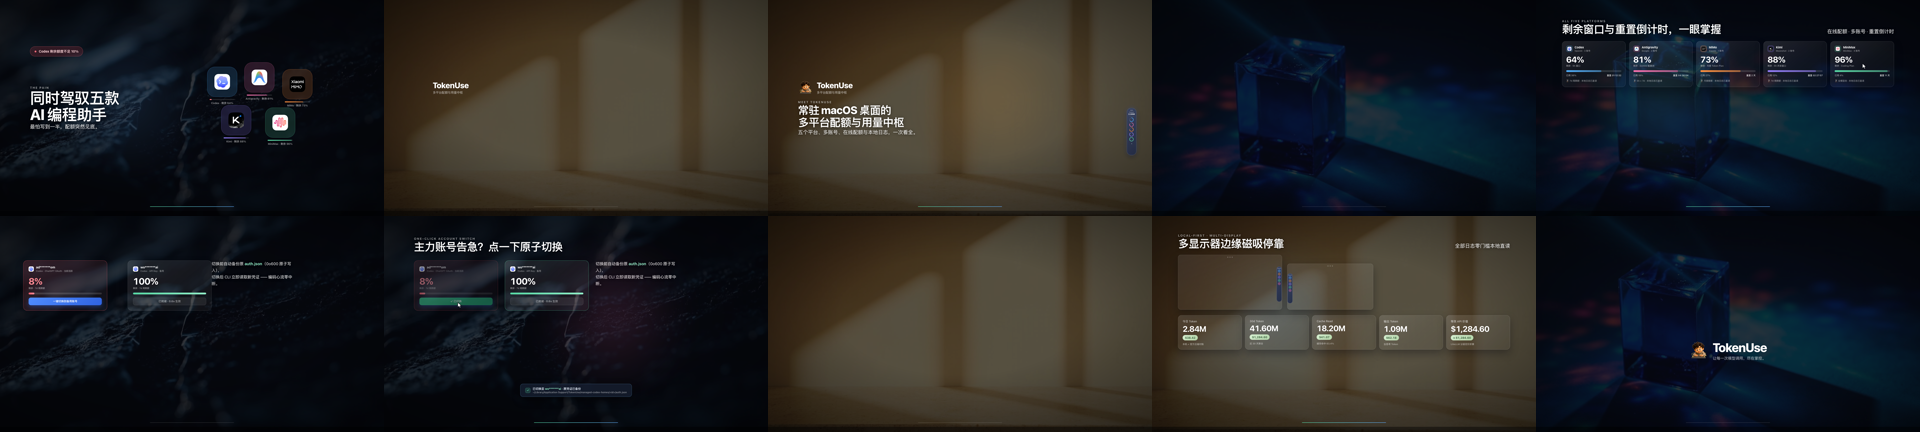
首轮 12 帧联络表probe-sheet.png刚渲出来,describe_images视觉审片立刻判定不通过,精准指出:“第 8 格底部的auth.json自动备份 Toast 弹窗压住了上方主标题,且暖光工作室底板上的浅色文字对比度偏弱。”MiniMax-M3随即把 Toast 移到底部安全区、将暖幕遮罩改为深暖墨色并增加文字投影,重跑探针后顺利过审。 - 第二次:听觉门禁立下奇功,抓出纯数值脚本完全失灵的致命杂音(Gate 3)!
首轮44.03 秒成片合成完毕后,常规的 FFmpegebur128响度脚本检测显示集成响度-14 LUFS完美达标——如果换成没有听觉理解能力的方案,这支坏片就已经被当成合格品交付了!
但当MiniMax-M3调用videos_understand真正去“看并听”这支 MP4 时,多模态模型直接拉响最高警报:“音轨严重损坏!全片充满刺耳撕裂杂音,完全听不到人声旁白!”
收到反馈后,MiniMax-M3立刻写诊断脚本比对混音前后波形,一针见血定位到了两处叠加的低级但致命的音频编码 Bug:Python 在将双声道数组写入wave时误排成了(2, N)平面序(标准 PCM 要求(N, 2)左右交错序),同时在转 16-bit 整型时误加了+32768无符号直流偏置导致严重反相削波!修复为标准交错有符号int16后,混音母带与人声干声的包络相关性直接从0.007飙升至0.97 ~ 0.99,二轮videos_understand终审一次性给出“人声清晰温润、音画严丝合缝,完全符合发布标准”的结论!
实战复盘金句:
-14 LUFS数值检测全绿,成片却全是撕裂杂音——多模态「真看真听」才是无人值守自动出片的最后一道保险。
(顺带一提,MiniMax 在实跑过程中还自己发现了单 Chrome 实例开 4 个后台标签页会被 Chromium 合成器节流降速到 1/4 的问题,当场重构为 4 个独立无头 Chrome 进程分片并行拉满多核;并移除了 FFmpeg 混流的 -shortest 参数,防止音频采样微差把视频末尾截掉 3 帧。)
四、眼见为实:Gemini、Kimi、MiniMax 三家成片与质检图谱同台对比
文字说得再多,不如直接看片。下面就是这个周末用同一套 TokenUse 源码,由三家原生全家桶各自独立产出的最终 1080p @ 60fps 成片与多模态质检图谱,大家可以直观感受三种截然不同的导演风格:
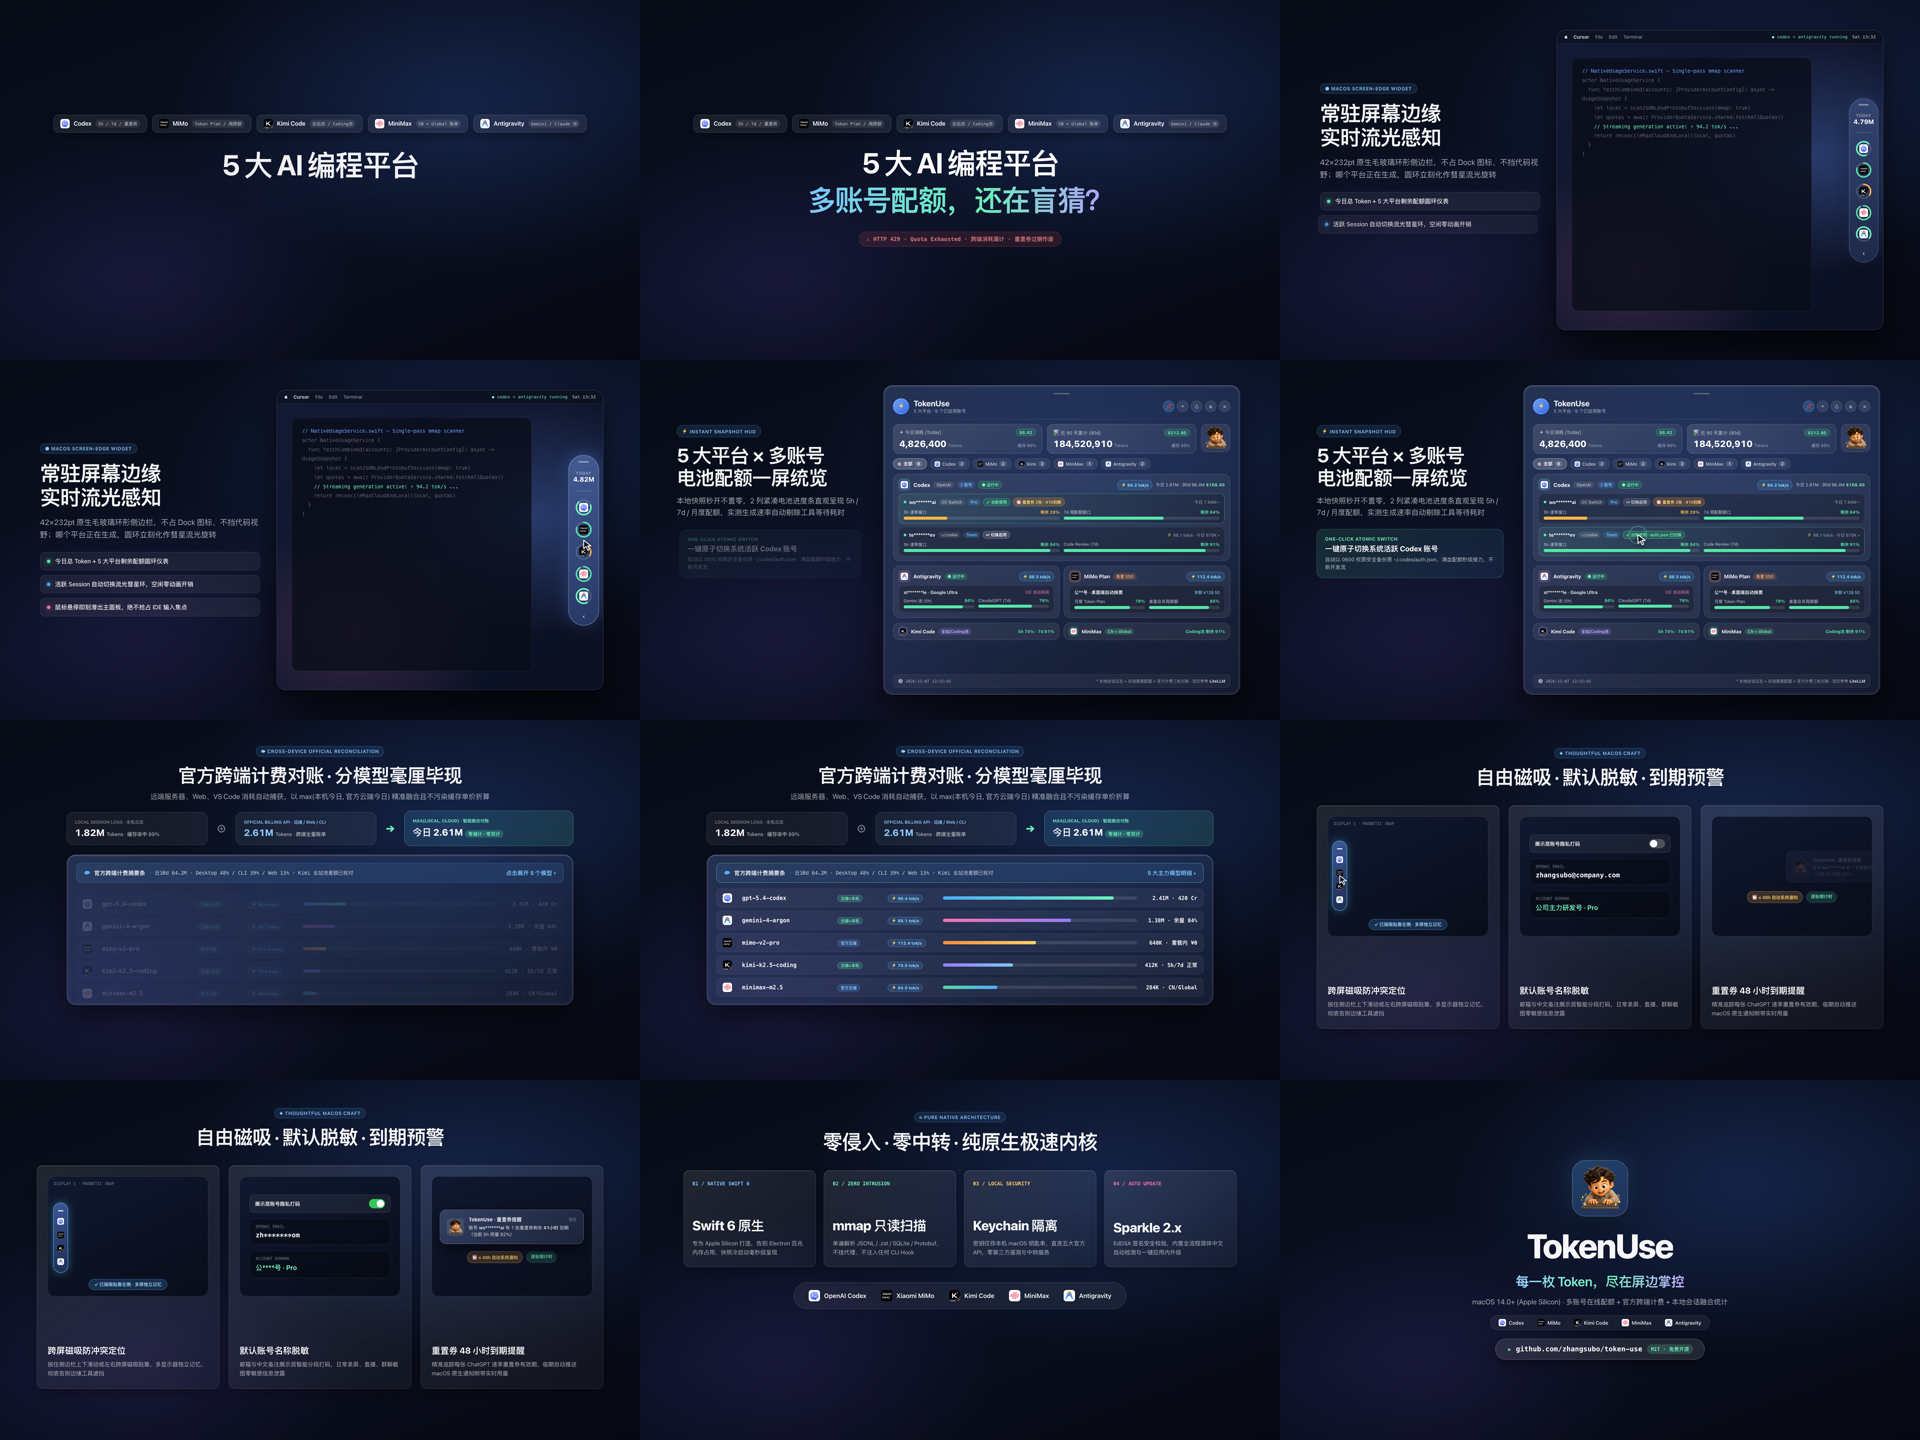
4.1 Gemini 版成片(24.00s · 连续深色毛玻璃桌面实机流)
- 看点提示:注意看第 2 秒屏幕右缘滑出的毛玻璃胶囊与蓝色彗星环、第 7 秒鼠标精准点击满血账号完成橙→绿热切换,以及 170° 快门模糊带来的丝滑跟手感。
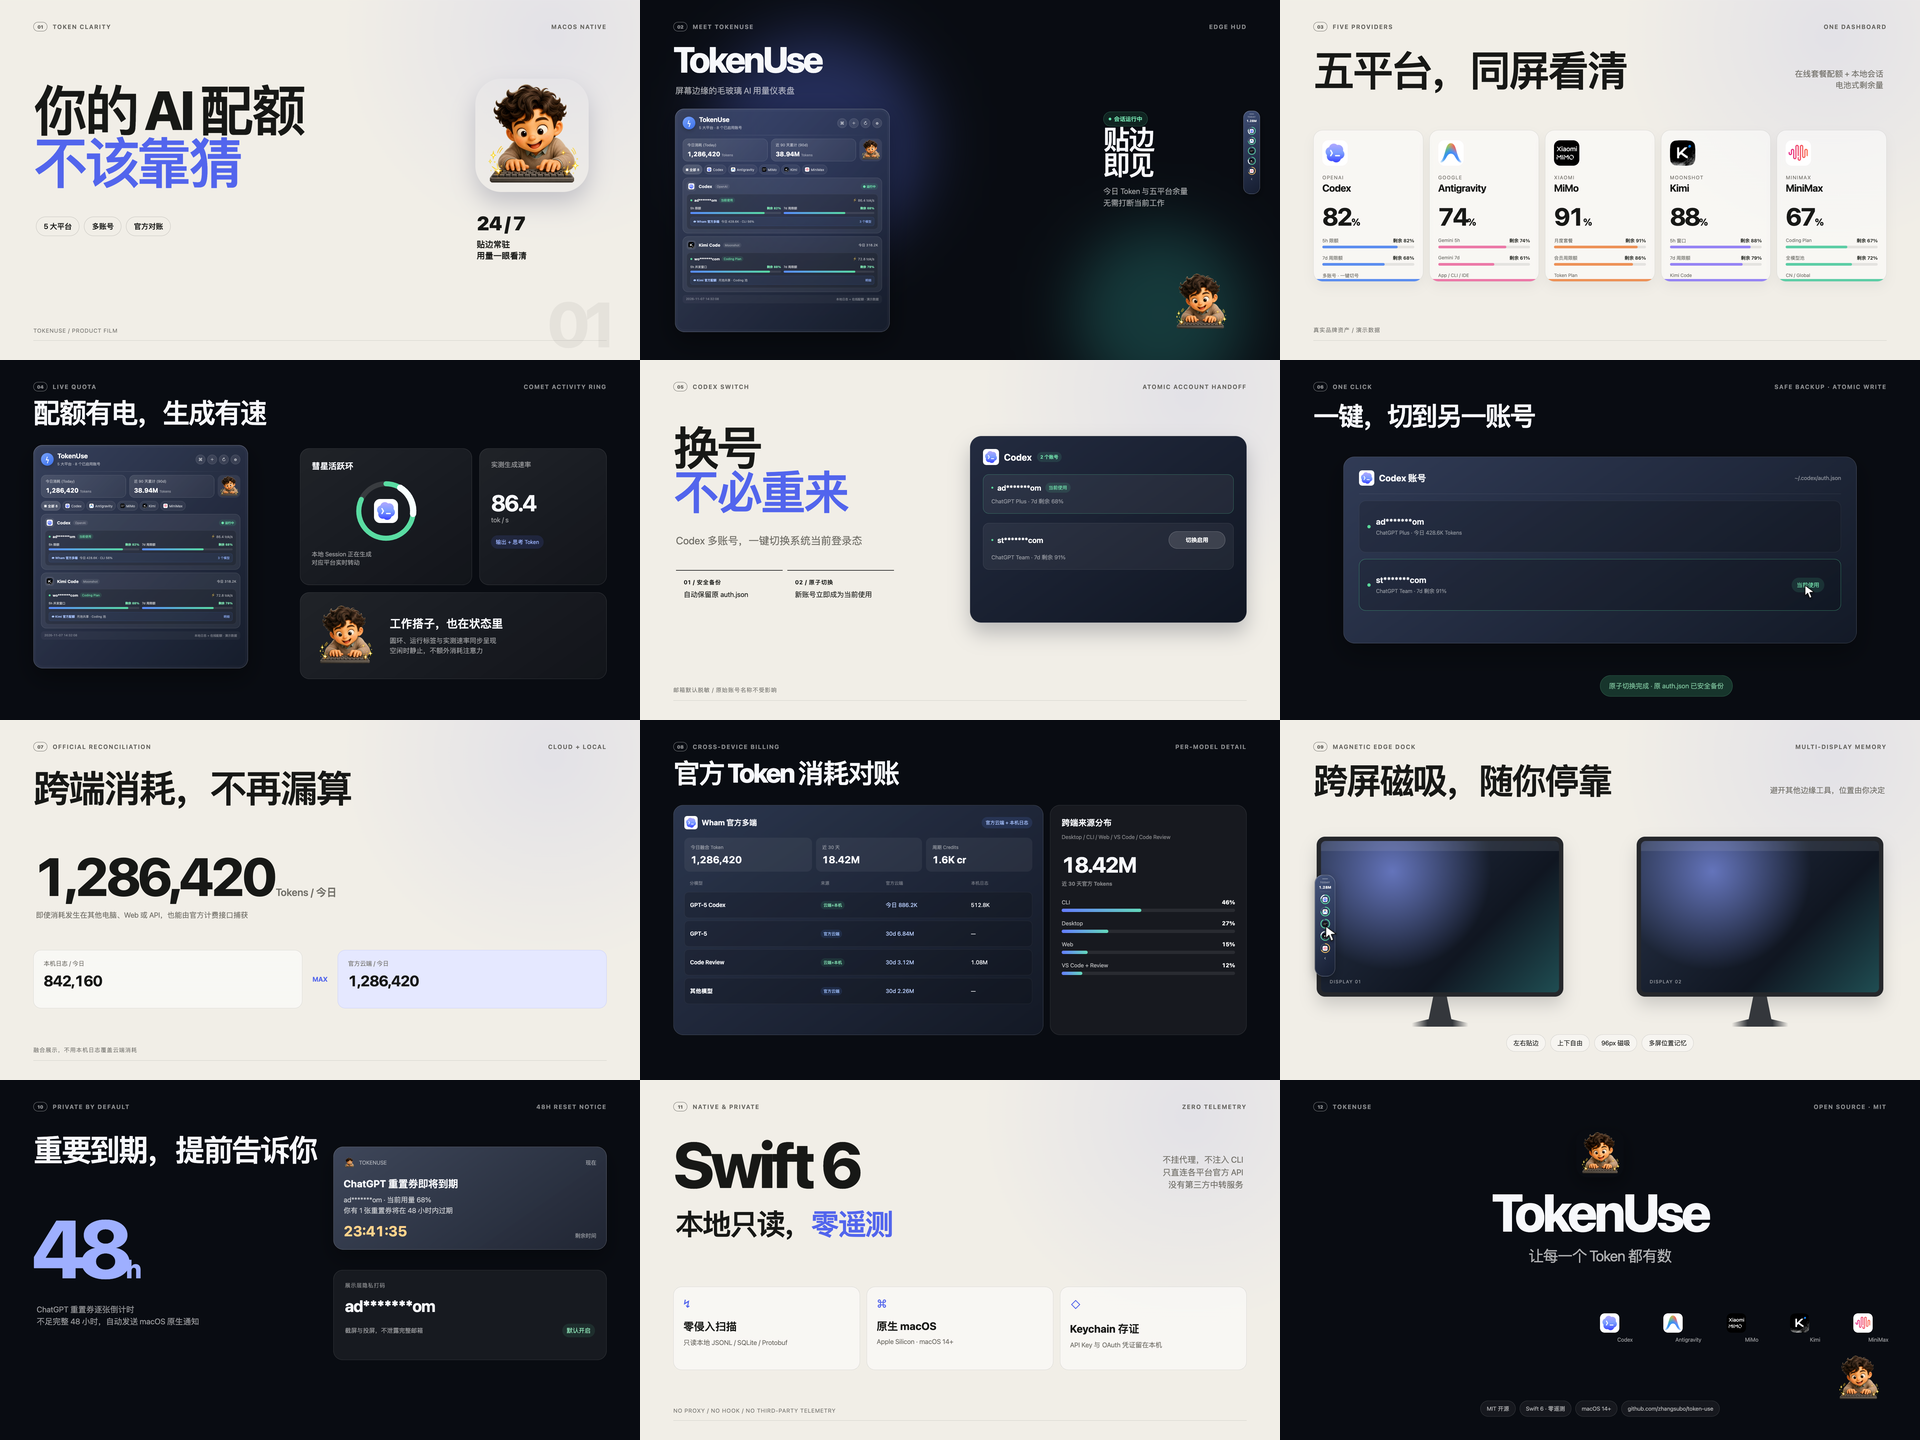
4.2 Kimi 版成片(24.00s · 瑞士国际主义暖白纸感 ↔ 曜石黑硬切流)
- 看点提示:注意看每 2 秒一小节的暖白大字报与暗色 Bento 实机幕硬切呼吸感、凝练的中文对仗标题,以及下方 Kimi 用来弥补无音频输入的声波卡点图与 11 切点零残影验证图。
4.3 MiniMax 三模态版成片(44.03s · 真人级发布会男声旁白 + 毫秒高亮字幕 + AI 光学底板)
- 看点提示:强烈建议开声音观看!感受
speech-2.8-hd发布会男声解说时背景电钢琴自动-7.5dB闪避的呼吸感、底部毫秒级同步高亮字幕,以及底层 3 张image-01摄影级光学底板与顶层锐利代码 UI 的融合质感。
五、精确到个位数的硬核账单:三方实测耗时与 Token 消耗全披露
拍完片子,最刺激的环节来了:让这三位 AI 导演各自独立拍完一支商业级宣传片,到底要烧掉多少时间、多少 Token?
为了保证数据 100% 零估算,我直接复用了 TokenUse 自身的底层遥测解析逻辑,从本机三套原生客户端的原始数据库与会话流中逐轮提取精确记录:
- Gemini(Antigravity):解析会话 SQLite 库(Protobuf 逐轮精确记录)与
transcript.jsonl,严格剔除前期阅读opus-video-prompts、撰写方案文档以及后续跨端调度 Orca / MiniMax 的全部外层轮次,仅保留纯视频制作的 36 轮; - Kimi Code(via Orca):解析独立视频会话
wire.jsonl全部 85 条usageScope = "turn"记录,并单独剥离 2 次终端临时目录清理菜单的人工按键等待时间(70.0s); - MiniMax Code(
mcode):解析~/.minimax/v2/sqlite/runtime-state.sqlite独立视频会话(119 轮),结合messages.jsonl毫秒级计时器做无重叠的「模型推理 vs. 工具执行」拆分,并合并voiceover-stats.json与image-stats.json的真实多模态调用量。
5.1 三方实测耗时与 Token 账单总表
| 指标维度 | Gemini 全家桶(Antigravity 直连 Gemini 4 Argon High) |
Kimi 全家桶(Orca 调原生 kimi-code/k3.1-pro) |
MiniMax 三模态全家桶(原生 mcode 调 MiniMax-M3 + 语音 + 图像) |
倍率参考(MiniMax / Gemini) |
|---|---|---|---|---|
| 成片时长与总帧数 | 24.00s / 1,440 帧 |
24.00s / 1,440 帧 |
44.03s / 2,642 帧 |
片长 1.83× |
| 成片视听形态 | 无旁白 · 电子合成配乐 | 无旁白 · 120 BPM 脉冲配乐 | 真人级男声旁白 + 同步字幕 + 3 张 AI 摄影底板 | 跨代升级 |
| Agent 交互总轮数(Turns) | 36 轮 | 85 轮 | 119 轮 | 3.31× |
| 总挂钟耗时(Wall-Clock) | 22 分 15 秒(1,334.6s) |
41 分 21 秒(2,480.9s) |
40 分 04 秒(2,404.4s) |
1.80× |
| 有效净工作耗时(扣人工等待) | 22 分 15 秒(零等待) | 40 分 11 秒(扣 70.0s 审批) |
40 分 04 秒(全自动零等待) | 1.80× |
| ├ 纯 LLM 模型推理耗时 | 18 分 43 秒(1,123.2s) |
29 分 44 秒(1,784.4s) |
22 分 34 秒(1,353.6s) |
1.21× |
| └ 工具、多模态 API 与渲染耗时 | 3 分 32 秒(211.4s) |
10 分 27 秒(626.5s) |
17 分 31 秒(1,050.9s)² |
4.97× |
非缓存主动 Token(In + Out) |
316,810(316.8K) |
493,572(493.6K) |
617,326(617.3K) |
1.95× |
| ├ 未命中缓存输入(Uncached Input) | 234,248 | 422,857 | 512,325 | 2.19× |
| └ 模型总输出(Output + Thinking) | 82,562 | 70,715 | 105,001 | 1.27× |
| 缓存读取 Token(Cache Read) | 账面 5,655,922 / 净值 ~2,950,168 ¹ |
15,891,480(15.89M) |
14,311,040(14.31M) |
净值 4.85× |
| 总计 LLM 吞吐(含 Cache Read) | 账面 5,972,732 / 净值 ~3,266,978 ¹ |
16,385,052(16.39M) |
14,928,366(14.93M) |
净值 4.57× |
| 单轮上下文峰值占用 | ~254K / 1M(25%) |
403K / 1M(40%) |
179K / 204.8K(峰值 178,956) |
0.70× |
| 额外多模态模型消耗 | 无(原生内建视听直读) | 无(内建 ReadMediaFile) |
speech-2.8-hd:212 字符(2.25s) / image-01:3 张 1080p 图(55.77s) / mcode-tools:4 次 图/视频审片 |
三模态独有 |
| 折算「每产出 1 秒成片」效率 | 55.6 秒 耗时 / 136K 净总 Token |
100.5 秒 耗时 / 683K 总 Token |
54.6 秒 耗时 / 339K 总 Token |
单位秒耗时最快 |
注 ¹(Gemini 缓存去噪说明):Gemini 会话前 4 轮做开源库调研读取的约
79.6K上下文留在了 Prompt Cache 中,被后续 36 轮视频制作重复命中(累计约2.71M),因此表中同时列出原始账面值(5.97M)与剥离前序缓存残留后的纯视频净值(3.27M)。
注 ²(MiniMax 17 分 31 秒工具耗时拆解):其中speech-2.8-hd并发合成 6 段语音仅耗时2.25s,image-01并发生成 3 张1920×1080底板耗时55.77s,其余约16m 33s主要花在多轮2,642帧(每轮需截取7,926张子帧!)的无头 Chrome 超采样渲染及 4 次多模态审片返工上。
5.2 从真实账单里挖出的 4 个反直觉洞察
把这张精确到个位数的账单摊开对比,能看到好几个平时光凭体感绝对猜不到的硬核规律:
- 大模型拍一支商业级代码视频的「有效产出常数」就在
70K ~ 105KOutput Tokens 之间
别被表里动辄15M、16M的总吞吐吓到!仔细看模型总输出(Output + Thinking):无旁白版 Gemini 输出了82.6K、Kimi 输出了70.7K;哪怕加上语音时间轴脚本、AI 底板脚本和两轮大修自愈,MiniMax 总输出也只有105.0K。
真正把总账单撑大到千万级的,是 Agent 循环轮数 × 当前上下文长度 滚出来的Cache Read(在 Kimi 和 MiniMax 中占比高达 95%~97%)。好在各家对缓存命中的计费通常只有普通输入的 10%~25%,在包月 Coding Plan 订阅制下更是毫无压力。 - MiniMax 的单轮推理速度极猛,折算「每秒成片耗时」反而是全场冠军
MiniMax-M3为了编排三模态脚本并完成两轮视听自愈,足足跑了 119 轮(是 Gemini 的 3.3 倍、Kimi 的 1.4 倍),但它的纯模型推理总耗时只有22 分 34 秒(平均每轮仅11.4 秒),比跑 85 轮的 Kimi(29 分 44 秒)整整快了 7 分 10 秒!而且上下文管理极克制(峰值仅179K),连Cache Read都比 Kimi 更省。更关键的是,由于人声旁白撑起了44.03 秒的完整叙事(片长是前两者的1.83 倍),折算每产出 1 秒 60fps 成片仅需54.6 秒挂钟时间,甚至以微弱优势反超了极速流的 Gemini(55.6 秒)! - 渲染挂钟时间的真正胜负手:管道图像格式与 Chrome 进程隔离
为什么 Gemini 的工具渲染只花了3 分 32 秒,而 Kimi 花了10 分 27 秒?核心差在截帧管道编码上:在180fps3 子帧超采样下,无损PNG管道渲染一次 24 秒视频要~270 秒,而改用JPEG (quality: 95)管道只需~90 秒(直接提速 3 倍),经过tmix多帧加权融合后肉眼完全无损。同时,用 4 个独立无头 Chrome 进程 替代“单浏览器开 4 个后台标签页”,才能彻底绕开 Chromium 后台标签页合成器节流,吃满 Apple Silicon 多核性能。 - 「数值硬断言」与「多模态真看真听」缺一不可
Kimi 证明了在没有音频输入能力时,靠「声波网格图 +ebur128数值断言」足以拦截96kHz升采样和真峰值过冲;但 MiniMax 的实战更深刻地证明:纯数值达标(-14 LUFS)根本测不出 PCM 声道错位与直流偏置带来的相位撕裂杂音。只有让多模态模型真正去“看画面、听声音”,才能打通无人值守自动出片的最后一公里。
账单核心结论:真正把账单撑到 1,500 万 Token 的不是废话,而是 96% 的廉价 Cache Read;商业级代码视频的有效代码产出常数,其实稳定收敛在
70K–105KTokens。
六、总结、开源指路与下一步探索:从「单兵作战」到「三家合体」与「Google 全家桶」
折腾完这一个周末,最大的感受是:当一项新玩法刷屏时,与其焦虑某个账号用不上,不如动手把它的底层工程链路拆干净。
一旦你把「用代码拍视频」拆解成确定性的 window.seek(t) 时间函数、闭式物理弹簧、无头浏览器并发超采样与多模态门禁,你会发现手头的模型各有各的绝活:
- 如果你追求 20 分钟极速出片、一镜到底的丝滑桌面实机演示,直接上 Antigravity + Gemini,百万上下文吃透源码加原生
.mp4视听双审,省心到极致; - 如果你偏爱 高密度中文观点卡点、瑞士杂志风大字报海报节奏,用 Kimi Code,它的中文凝练度与严丝合缝的切点秩序感会给你惊喜;
- 如果你要做 正式对外的产品发布大片,需要温润自然的真人级配音解说、毫秒同步字幕与摄影级背景光影,MiniMax Code(
mcode)三模态全家桶是目前唯一把「文字代码 + 语音主时钟 + AI 摄影底板 + 视听审片自愈」跑成完整闭环的方案,一个订阅全包圆。
我已经把这个周末沉淀下来的全套方法论文档、Gemini / Kimi / MiniMax 三家可直接复制(Copy-Ready)的 Playbook 与导演角色提示词、零外部 npm 依赖的三套完整实战源码工程(双击 index.html 即可在浏览器拖拽时间轴实时预览),以及标准化的 Agent Skills 技能包矩阵,全部整理成了一个独立的 MIT 开源仓库发布到了 GitHub。
无论你平时主力用的是 Claude Code、Cursor、Antigravity 还是 OpenClaw,现在都可以一行命令直接装入总控导演 Skill,给你自己的开源项目或新产品拍一支 60 帧大片:
npx -y skills add zhangsubo/code-video --skill code-video-director
📦 开源仓库与致谢指路(可直接长按复制,或点击文末左下角「阅读原文」直达)
- 本文全套代码拍视频工坊 & Agent Skills:
https://github.com/zhangsubo/code-video- 测试标的 macOS 多平台配额监控应用
TokenUse:https://github.com/zhangsubo/token-use- 特别致谢:感谢开源仓库
https://github.com/joeseesun/opus-video-prompts维护者及其中无私公开原版提示词与案例的各位社区作者(@twoclipping、Danny Stuart、WY、Deedy 等),正是这些开放的一手沉淀,让这次跨模型工程化探索少走了太多弯路。
最后留两个悬念:
- 今天展示的这三支成片,是为了摸清各家能力边界而让它们分别“单打独斗”跑出来的;但一圈实测下来,它们三家的长板实在太互补了——比如让 Gemini 凭百万上下文做全仓源码穿透与最终
.mp4原生视听终审,让 Kimi 操刀凝练有力的中文分镜文案与瑞士网格排版,再把 MiniMax 的发布会级人声主时钟与 AI 摄影光学底板接进来。目前我还在继续探索把这三个模型串联起来综合使用、各取所长的混合制片工作流。 - 另外在实验的过程中,我完全忘掉了 Google AI 套餐本身其实有送 Google Cloud Credits 可以用来抵扣 Gemini API 付费层的账单,还有 Google Flow / Whisk 的 AI Credits!回头我用纯血 Google 全家桶也试一下,后续跑出结果一并跟大家拆解分析!